322 字节的 404,写掉了 577 GB:一次磁盘写满事故的完整取证
早上八点五十,Mac mini 弹了一条磁盘告警:可用空间 2.8 GB。
但这台机器的 Data 卷明明写着 Size 228Gi / Used 168Gi。相减还有 60 GB。
更奇怪的是另两件事:内存占用排行榜上有个系统进程占了 36 GB(机器总共只有 16 GB);而这块 SSD 今天已经写进去 731 GB。
三件事看起来互不相关。事后证明它们是同一条因果链。
一、环境
先把出事的这台机器和当时的状态列清楚,后面所有数字都出自这里。
| 项目 | 值 |
|---|---|
| 机型 | Mac mini(Mac18,5) |
| 芯片 | Apple M6,12 核(2 Super / 4 Performance / 6 Efficiency) |
| 内存 | 16 GB |
| 系统 | macOS 27.3(26C5047e) |
| 内置盘 | APPLE SSD AP0256Z,251 GB,APFS |
| 浏览器 | Google Chrome 158.0.8127.37 |
| 事发时刻 | 开机 9.5 小时后(00:29 开机,08:56 告警) |
盘上的 APFS 结构:
disk0                        251 GB
├── ISC (iSCPreboot)         576 MB
├── APFS Container           245.05 GB
│   ├── Macintosh HD          13.8 GB   (System, 只读)
│   ├── Macintosh HD - Data  180.1 GB   (Data)
│   ├── VM                    34.4 GB   ← 关键
│   ├── Preboot               11.6 GB
│   └── Recovery               2.0 GB
└── Recovery 分区              5.37 GB
还有一个不起眼的事实:这台机器上装着两个自制的 Chrome 扩展开发环境,其中一个(多平台视频发布插件)用独立的 Chrome profile 跑,并且开着 CDP 远程调试端口 9333,方便脚本驱动。
二、矛盾在哪
三个数字先摆出来:
df /System/Volumes/Data     →  Avail 2.8 Gi
system_profiler 内存排行     →  fseventsd  MEM 36 GB
iotop 类工具(top)         →  Disks written 681 GiB
Avail 2.8 Gi 和 228 − 168 = 60 Gi 的差额,在 APFS 里叫「容器共享」。
APFS 的多个卷跑在同一个容器里,空间是共享的。df 报某个卷的 Used 时,只算这个卷自己用掉的块,兄弟卷占的块不计入。但可用空间是容器级的。
所以:
数据卷自己用了        168 Gi
System  + Preboot     25.4 Gi
Recovery              2.0 Gi
VM(swap)            34.4 Gi
                     ─────────
合计                  230 Gi  → 容器只剩 3 Gi
那个「60 G 可用」是 228 减 168 算出来的幻觉,从来没存在过。 真实的可用空间只有 Avail 那一列。
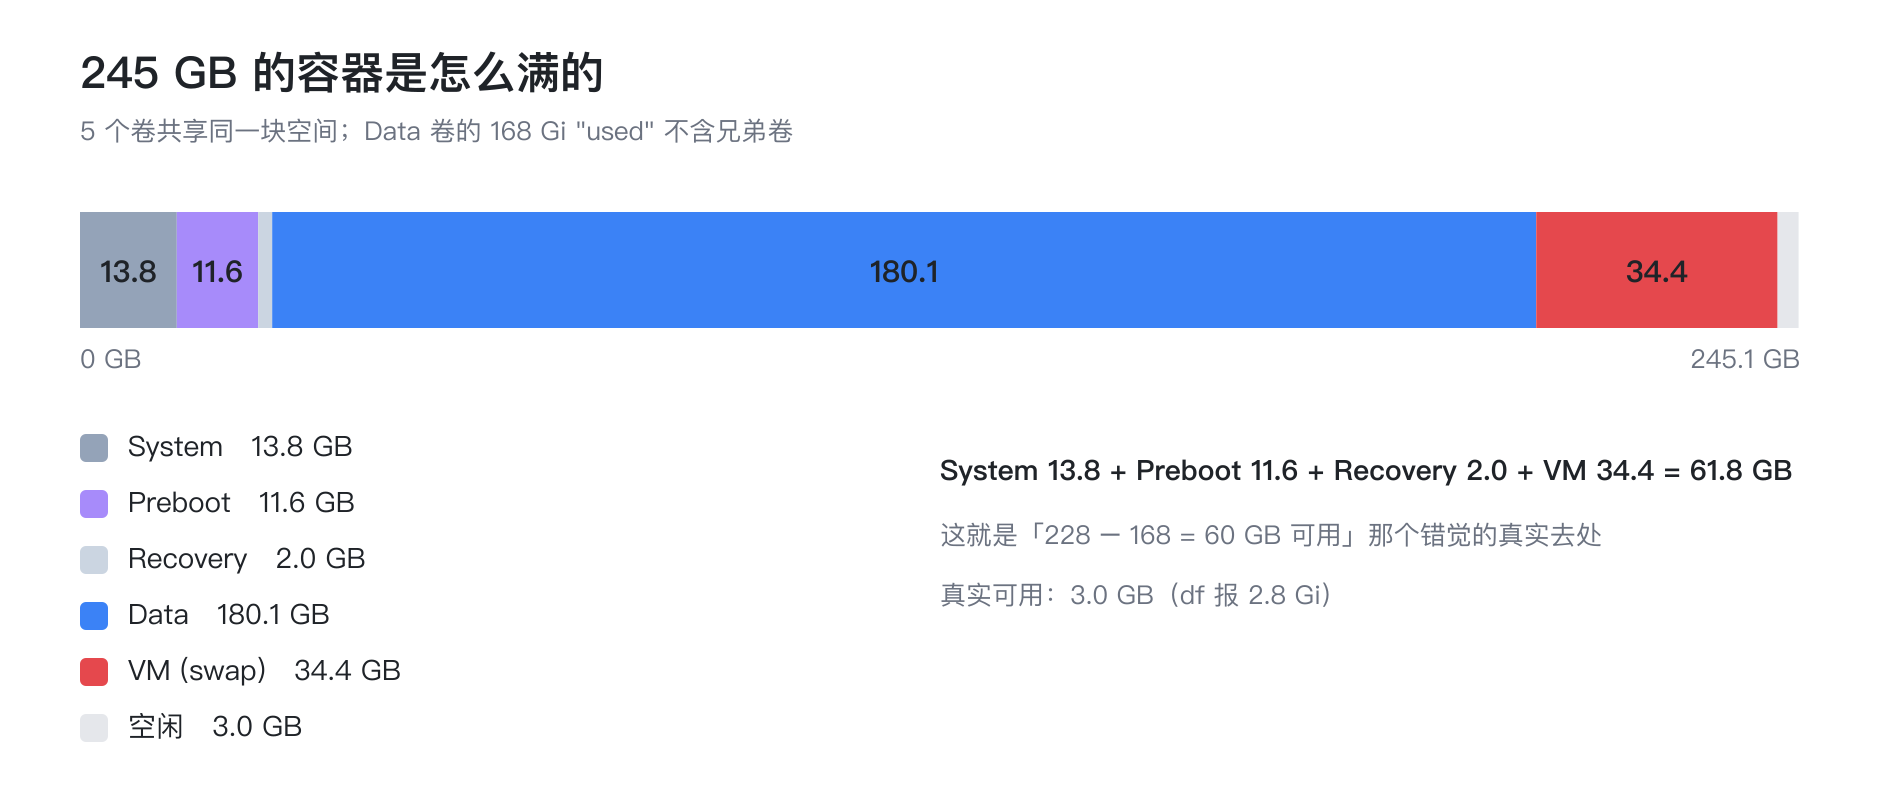
那 VM 卷是什么?32 个 1 GB 的 swapfile,安静地躺在 /private/var/vm/ 里——Finder、关于本机、磁盘工具都不会显示这个卷。
所以真正要回答的问题变成了两个:
- 为什么会有 34 GB 的东西被换出到 swap?
- 为什么这块盘 9.5 小时被写了 731 GB?
三、定位方法(这部分可以复用)
排查"谁在写盘",光看 top 的 CPU 列是不够的。我用了四层证据,一层比一层硬。
第 1 层:设备级计数器
ioreg 能直接读 IOBlockStorageDriver 的累计读写字节数,不需要 root:
ioreg -c IOBlockStorageDriver -r -d 1 | grep -E "Bytes \(Write\)|Operations \(Write\)""Bytes (Write)" = 731,672,031,232
"Operations (Write)" = 151,729,139这两个数一下就把话说死了:731.7 GB,1.5 亿次写操作,平均每次 4.82 KB。
不是顺序写大文件,是海量的小随机写。
第 2 层:进程级计数器
top 的 CPU 列会骗人,ps 的 RSS 也会骗人。真正可靠的是内核维护的 per-process 磁盘 I/O 记账,通过 proc_pid_rusage() 的 RUSAGE_INFO_V4 取:
#include <stdio.h>
#include <stdlib.h>
#include <libproc.h>
#include <sys/resource.h>

int main(int argc, char **argv) {
    struct rusage_info_v4 ri;
    for (int a = 1; a < argc; a++) {
        pid_t pid = atoi(argv[a]);
        if (proc_pid_rusage(pid, RUSAGE_INFO_V4, (rusage_info_t *)&ri) != 0) {
            printf("%d ERR\n", pid);
            continue;
        }
        printf("%d %llu %llu\n", pid, ri.ri_diskio_bytesread, ri.ri_diskio_byteswritten);
    }
    return 0;
}
clang -O2 -o /tmp/iotrack iotrack.c
/tmp/iotrack $(pgrep -f "Google Chrome")
sleep 15
/tmp/iotrack $(pgrep -f "Google Chrome")15 秒的增量排名:
284.55 MB    PID 10090  Google Chrome Helper (Aperitif)
  2.25 MB    PID 1204   python(某后台服务)
  0.29 MB    PID 3388   OrbStack Helper
  ...        其余 653 个进程合计 < 3 MB
97% 的写入来自一个进程。 而且它不是主进程,是 --type=utility --utility-sub-type=network.mojom.NetworkService —— Chrome 的网络服务子进程。
第 3 层:调用栈
sample 抓 2 秒,看它到底卡在哪个系统调用上:
sample 10090 2 1 -file /tmp/sample.txt热点帧:
open → ftruncate → pwrite → close → __unlinkat → fsync全在 Google Chrome Framework 的 NetworkService 线程池里。这是典型的磁盘缓存条目维护:建条目、写数据、更新索引、淘汰旧条目。
第 4 层:谁在触发它
到这一步只知道了"Chrome 的网络进程在疯狂写盘",但 Chrome 自己不会无缘无故每秒发几千个请求。用 CDP 连上调试端口,直接问页面:
curl -s localhost:9333/json/list | python3 -m json.tool结果里有个 sidepanel.html 的 target。用 CDP 求值:
performance.getEntriesByType('resource').length5 秒后再求一次,差值是 24,771。
performance.getEntriesByType('resource')
  .slice(-5)
  .map(e => e.name)
http://127.0.0.1:8765/poll
http://127.0.0.1:8765/result
http://127.0.0.1:8765/poll
http://127.0.0.1:8765/result
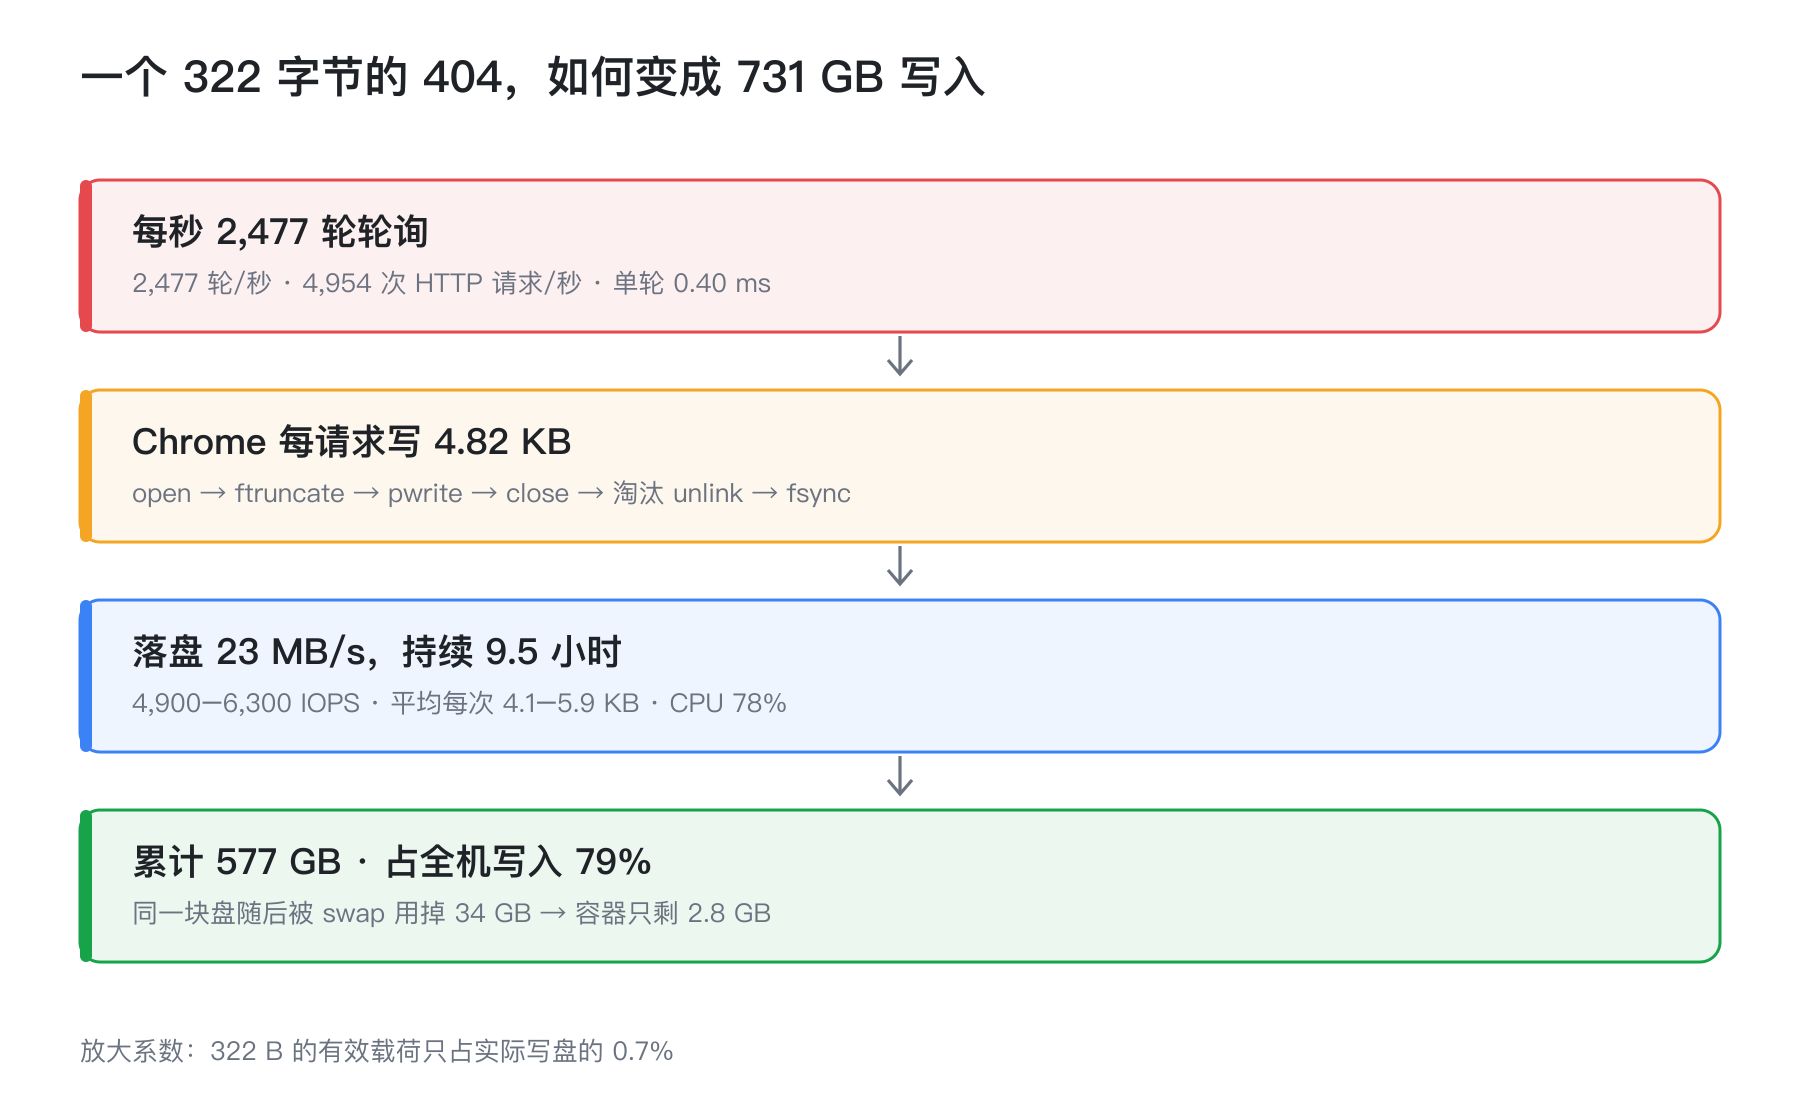
http://127.0.0.1:8765/poll每秒 4,954 次请求,全打向本机的 8765 端口。 每轮两发(/poll + /result),也就是 2,477 轮/秒,单轮 0.40 ms。
到这里,因果链的"点火者"找到了。
四、8765 上蹲着的是谁
先看这个端口的占用者:
lsof -nP -iTCP:8765 -sTCP:LISTENCOMMAND PID USER FD TYPE NAME
uvicorn 812 <user> 7u IPv4 TCP 127.0.0.1:8765 (LISTEN)uvicorn —— 那是另一个项目(邮件摘要服务)的 FastAPI 后端,由 LaunchAgent 托管,KeepAlive 为 true,开机自启,00:39:22 启动。
而"应该"占着 8765 的那个服务——插件的 tools/bridge-server.mjs——根本没在跑。它没有 LaunchAgent,需要手动 node tools/bridge-server.mjs 启动。
现在两个服务的契约摆在一起,问题就出来了。
客户端:lib/devbridge.js
const BASE = 'http://127.0.0.1:8765';

export async function startDevBridge() {
  const self = await chrome.management.getSelf();
  if (self.installType !== 'development') return;
  for (;;) {
    let cmd;
    try {
      const r = await fetch(`${BASE}/poll`);
      if (r.status === 204) continue;          // 长轮询超时 = 没有命令
      cmd = await r.json();
    } catch {
      await new Promise(res => setTimeout(res, 3000));
      continue;
    }
    let body;
    try { body = { id: cmd.id, ok: true, result: await handle(cmd) }; }
    catch (e) { body = { id: cmd.id, ok: false, error: String(e && e.message || e) }; }
    try { await fetch(`${BASE}/result`, { method: 'POST', body: JSON.stringify(body) }); } catch { /* 服务端已关 */ }
  }
}服务端:tools/bridge-server.mjs
if (req.method === 'GET' && url.pathname === '/poll') {
  const w = { res, timer: setTimeout(() => { waiters.splice(waiters.indexOf(w), 1); send(res, 204); }, 20000) };
  waiters.push(w); dispatch(); return;
}
...
}).listen(8765, '127.0.0.1', () => console.log('bridge on 127.0.0.1:8765'));设计意图很清楚:这是一个长轮询。没有命令时,服务端挂着请求 20 秒不返回,超时后才回 204。有命令则立刻回 200 + JSON。
也就是说,正常情况下客户端每 20 秒才发一次请求。客户端不设任何间隔是对的——间隔由服务端的长连接提供。
而实际上回应它的,是 uvicorn
curl -i http://127.0.0.1:8765/pollHTTP/1.1 404 Not Found
content-type: application/json
{"detail":"Not Found"}两件事同时成立:
- 它立刻返回,不等 20 秒(因为压根没有
/poll这个路由) - 它返回的是合法 JSON
五、为什么 404 没能让循环慢下来
回到那段循环,逐个分支看:
const r = await fetch(`${BASE}/poll`);
if (r.status === 204) continue;   // 404 ≠ 204,跳过
cmd = await r.json();             // ← 关键:这是合法 JSON,不抛异常
r.json() 不会抛异常。{"detail":"Not Found"} 是一个完全合法的 JSON 对象。所以请求虽然失败了,但代码不认为它失败了——它只判断了"是不是 204",没有判断"是不是 200"。
于是 cmd = {detail: "Not Found"},继续往下:
body = { id: cmd.id, ok: true, result: await handle(cmd) };cmd.op 是 undefined,handle() 走到 default 分支:
default: throw new Error(`未知命令 ${cmd.op}`);这个 throw 在第二个 try/catch 里,被就地转成 {ok:false, error:"未知命令 undefined"} 的 POST 请求发出去,然后 for(;;) 进入下一轮。
整条路径上:
- 唯一的
setTimeout(3000)在第一个 catch 里 —— 只有网络层真正抛异常才会走到 handle()抛错走的是第二个 catch —— 那里没有等待status === 204那条continue—— 404 不满足
没有任何分支会让它慢下来。 循环速率不再受服务端长轮询约束,改由本机 RTT 决定:两次 loopback 往返 + 一次 JSON 解析 ≈ 0.40 ms。
这就是每秒 2,477 轮的来源。
六、Chrome 怎么把 322 字节放大成 23 MB/s
一个 322 字节的 404 响应,凭什么产生每秒 23 MB 的磁盘写入?
因为请求不在页面进程里执行。每一次 fetch 都要转给 Chrome 的 NetworkService 子进程,而它对每个 HTTP 请求都有一套固定开销:
open 建缓存条目 → ftruncate 定长 → pwrite 写数据 → close
→ 更新 HTTP 缓存索引 → 淘汰超限的旧条目(unlink)→ 必要的 fsync
这四步 sample 全抓到了。而且它是冷路径:缓存条目要落盘,不能只在内存里。
算一下就很直白:
23 MB/s ÷ 4,954 请求/s ≈ 4.6 KB 落盘 / 每个请求
响应体 322 B ÷ 4.6 KB ≈ 0.7%
有效载荷只占实际写盘的 0.7%。
还有一个佐证:设备级 Operations (Write) 是 151,729,139 次,而按 4,954 请求/秒 × 8.4 小时算出来是约 1.5 亿次请求。写操作次数和请求次数几乎 1:1。
写盘归属:一个进程吃掉 79%
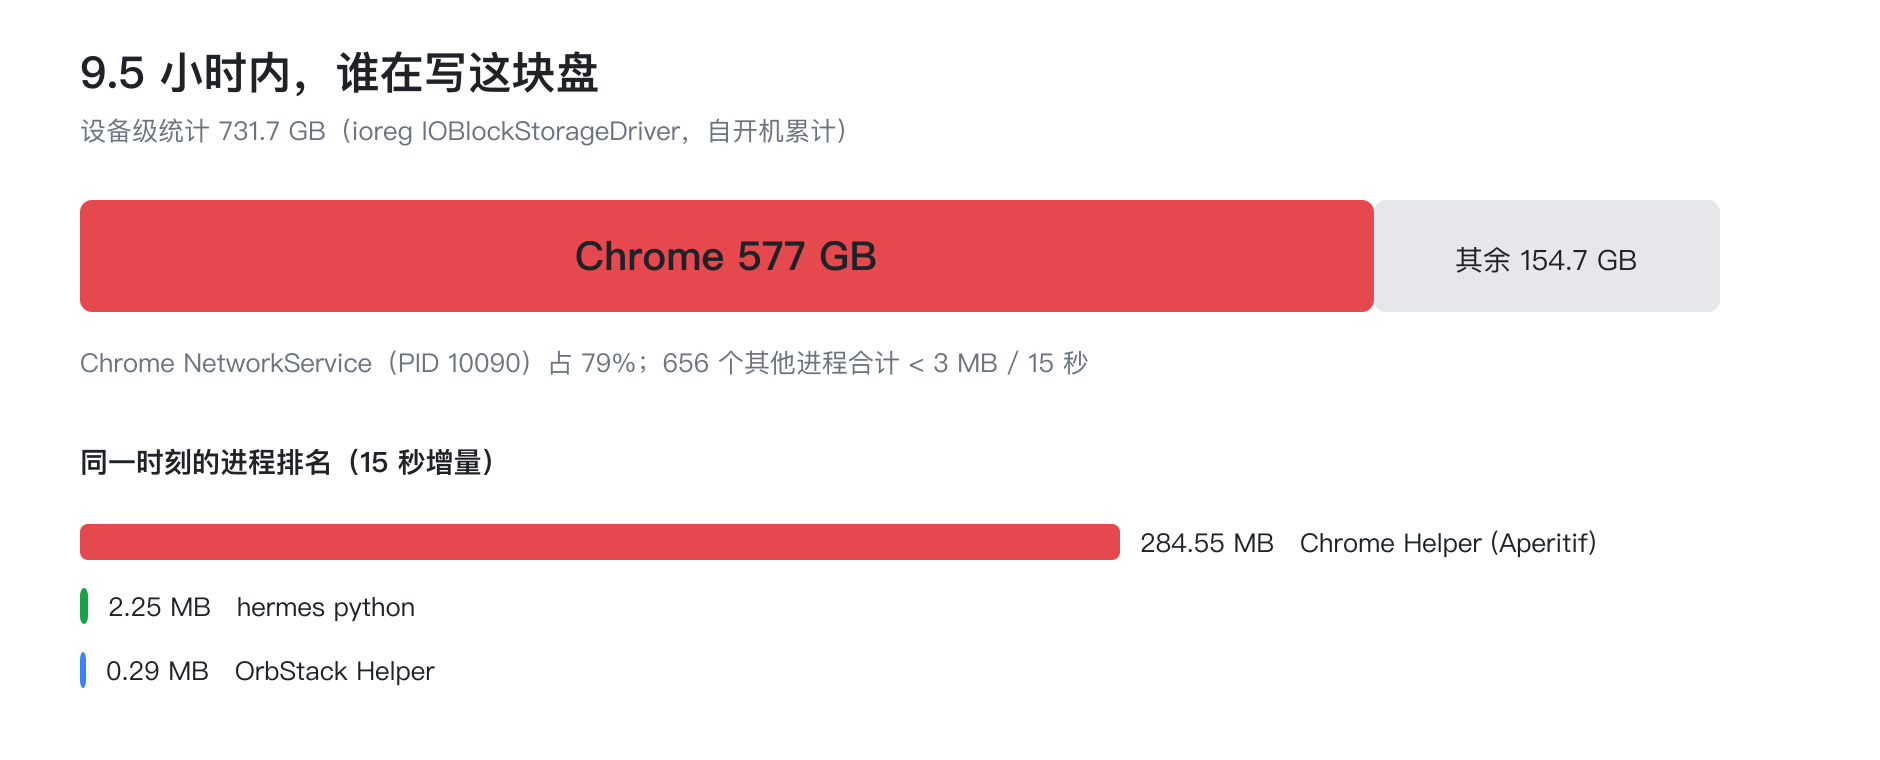
9.5 小时里设备级累计 731.7 GB,其中 Chrome NetworkService(PID 10090)占 577 GB,79%。
同期的 CPU:PID 10090 常驻 78.4%,累计消耗 374 分钟 CPU 时间。这台机器只有 12 个核,其中 6 个是能效核。
第二层放大:文件系统事件
上面每一次 open/close/unlink 都会在内核产生一个 vnode 事件,按卷排队,由 fseventsd 消费并持久化成 .fseventsd/<序号> 日志文件。
| 指标 | 出事这台 mini | MacBook Pro(对照) |
|---|---|---|
.fseventsd 条目增长 |
0.8 个/秒 | 135 秒内 0 |
| 8.7 小时累计 | 17,485 个 | 1,220 个(跑了一整天) |
| fseventsd 系统调用 | 9 分钟 1,113 万次 | 24 小时 4,878 万次 |
同一时段 fseventsd 打印了三次:
event logs ... with volume UUID [...] and f_flags[0x4a09218] out of sync with volume.
destroying old logs. (64 31045 31681)
括号里是 (日志序号, 磁盘上记的 last_event_id, 卷当前 event_id)。31045 vs 31681,落后 636 个事件。它判定磁盘上的日志已经追不上卷的状态,于是"销毁旧日志、重建"。
重建完还是追不上,再销毁,再重建。
七、36 GB 内存和 34 GB swap
到这里链路还差最后一环:内存是怎么涨到 36 GB 的。
先排除误读。top 的 MEM 列显示 36 GB,但:
ps -o rss= -p 84560        # → 243 MB
vm_stat                    # 压缩器占用 7.5 GB,匿名页 3.6 GB
RSS 只有 243 MB。 那 36 GB 既不在常驻内存里,也不在压缩器里——它只能是已经被换出到 swap 的匿名页,而这些页仍记在 fseventsd 名下。
决定性验证:重启这个进程。
sudo launchctl kickstart -k system/com.apple.fseventsdswap 34,424 MB → 1,977 MB
VM 卷 34.4 GB → 3.0 GB
可用空间 2.8 Gi → 24 Giswap 释放了 32.4 GB,和它名下的 36 GB 基本吻合。归属确认。
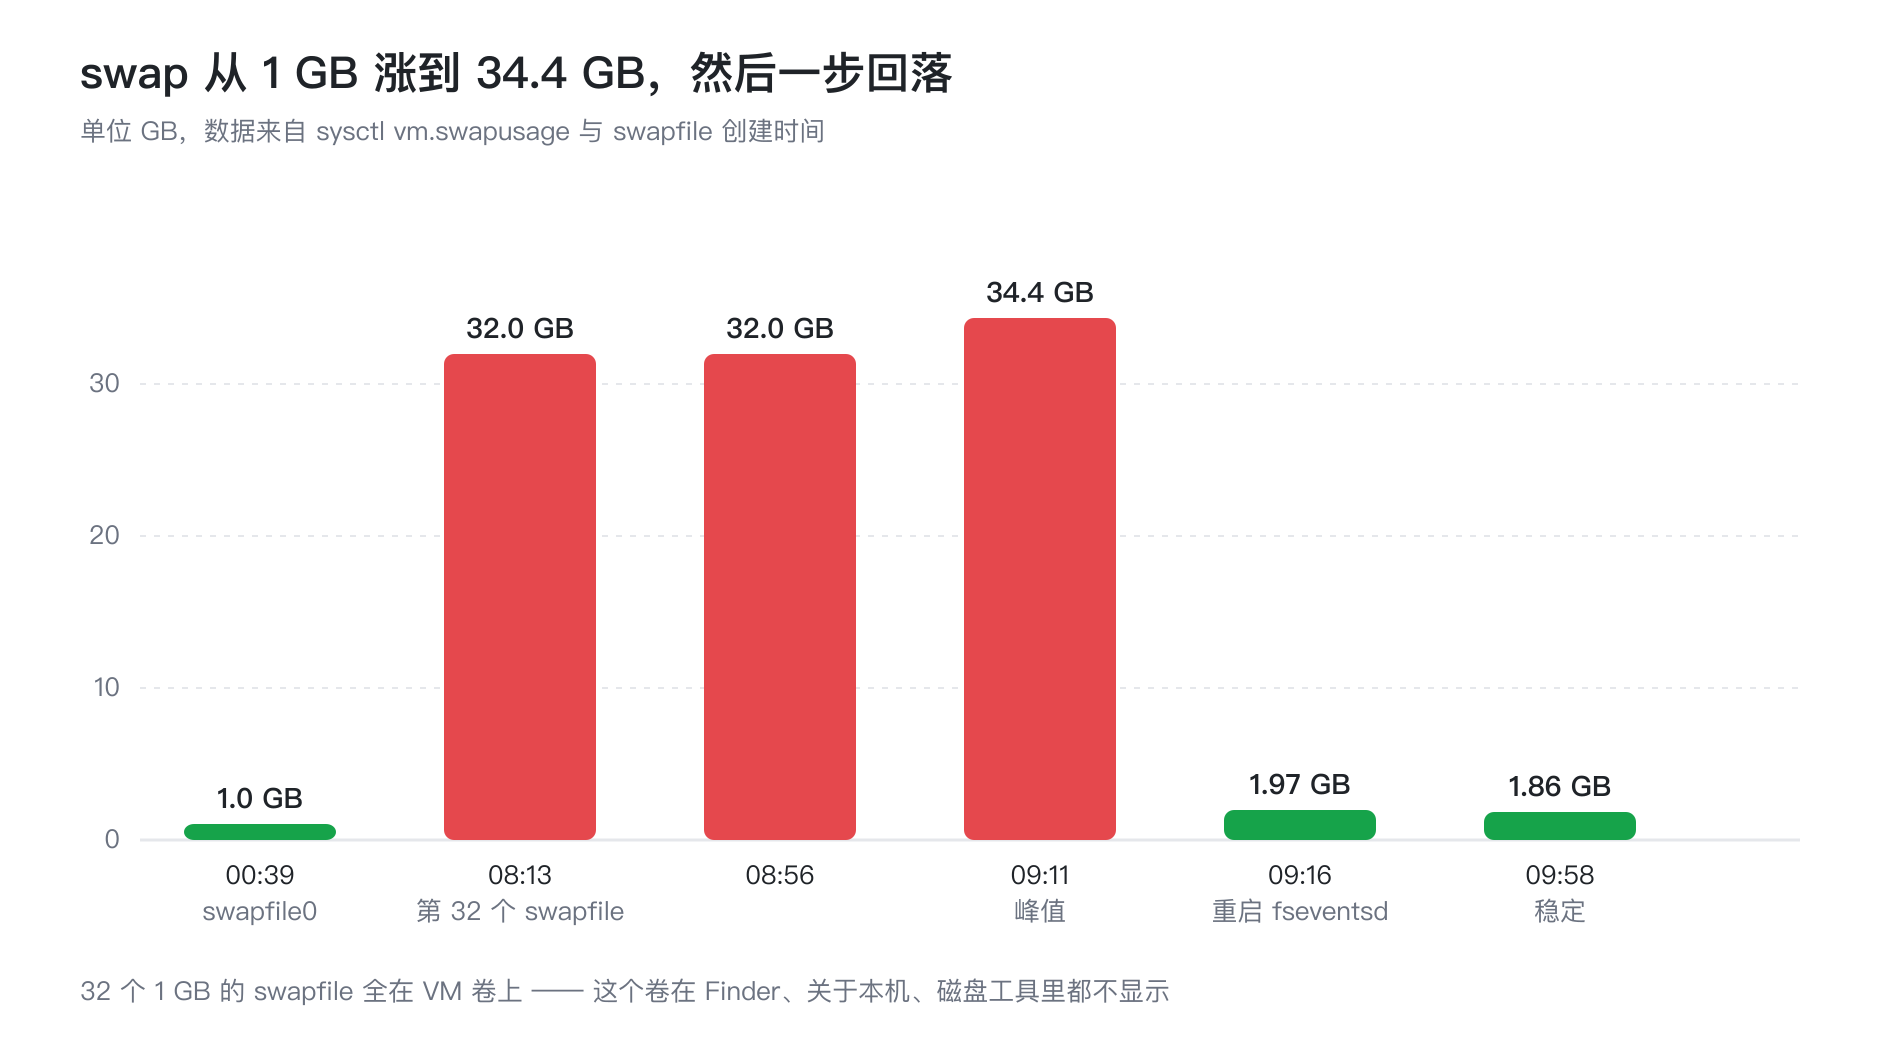
至于为什么会涨:每一轮"destroying old logs → 重建"都重新分配一套事件缓冲区和索引,旧的没被释放。这一条是推断,不是实测——要坐实需要在泄漏过程中用 root 抓 vmmap / heap,而进程已经被重启,那次机会错过了。能确认的是:泄漏的量级与重建的次数、时长成正比。
然后是第三步:dynamic_pager 把换出的页写成 /private/var/vm/swapfileN,每个 1 GB,落在 VM 卷上。34 个 swapfile = 34 GB,正好把只剩 3 GB 的容器填满。
一个 322 字节的 404 响应,最后变成了 34 GB 的磁盘占用。
八、后果
磁盘
容器从 245.1 GB 满到只剩 2.8 GiB。系统开始拒绝写入,各种应用报错。
SSD 磨损
这是最容易被忽略、也最贵的一条。读一下这块盘的真实健康度(smartctl 不需要 root 就能读 Apple 内置盘):
Model Number:        APPLE SSD AP0256Z
Percentage Used:     1%
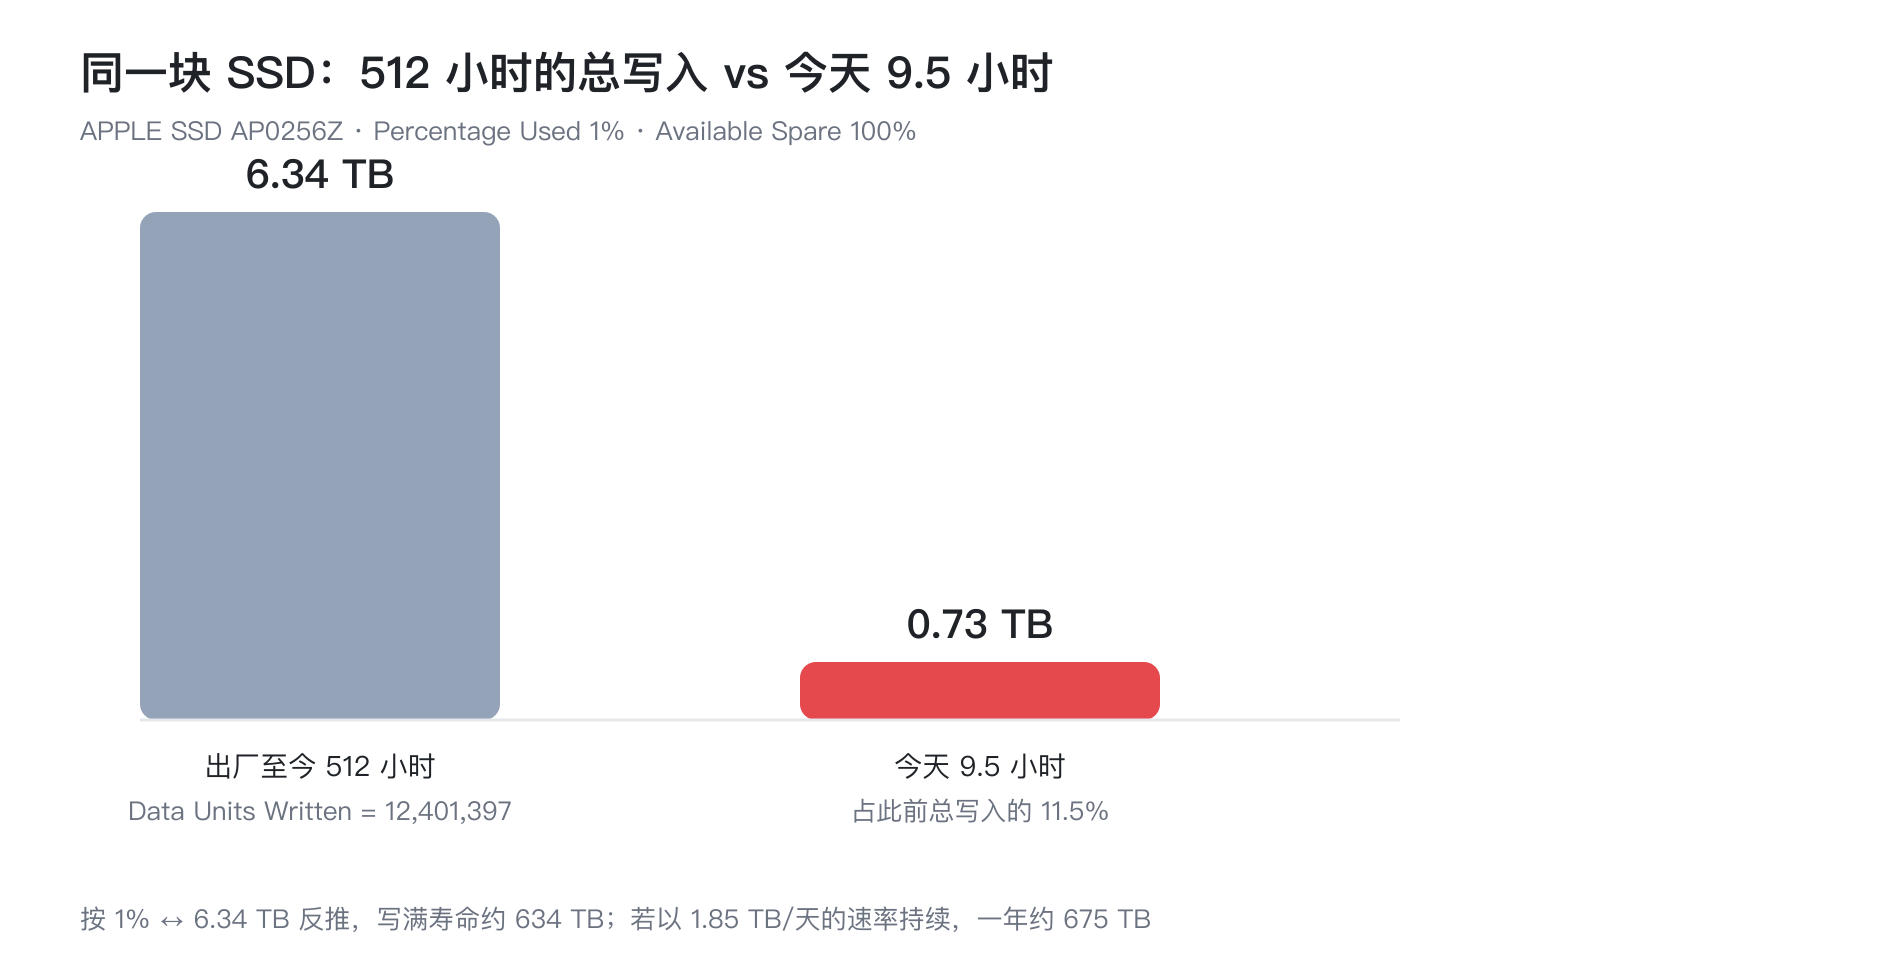
Data Units Written:  12,401,397 [6.34 TB]
Power On Hours:      512
Available Spare:     100%
Media Errors:        0
对照一下:
| 出厂至今(512 小时)总写入 | 6.34 TB |
| 今天 9.5 小时写入 | 0.73 TB |
今天一天写了它整个生命周期写入量的 11.5%。 而这块盘才通电 512 小时。
按「1% ↔ 6.34 TB」反推,写满寿命大约 634 TB(因为 1% 是取整,真实区间约 420 TB – 1.27 PB)。照 1.85 TB/天跑下去,一年约 675 TB。
还有一层隐藏成本:主机侧每次写 4.82 KB,但 NAND 的最小写入单元是页(TLC 通常 16–32 KB)。这么小的随机写会让主控做 read-modify-write,实际烧在 NAND 上的量高于主机记账的量。这部分 Apple SSD 不暴露,属于推断。
好在这盘 Percentage Used 还是 1%,Available Spare 100%,没有媒体错误——损伤还在噪声范围内。真正贵的是"如果没发现":连续跑一个月是 55 TB,两个月 110 TB。
IOPS 挤占
4,900–6,300 IOPS 持续了 8 个多小时。这台机器上其他所有应用的操作都在这条队列后面排队——磁盘"变慢"的感受,源头在这里。
九、止血:一次干净的 A/B
定位不需要靠猜,因为关掉触发源之后所有指标应该同步归零。用 CDP 关掉那个侧边栏页面(不改任何代码、不改任何配置):
curl -s localhost:9333/json/close/<targetId>| 指标 | 关闭前 | 关闭后 |
|---|---|---|
| PID 10090 累计写入 | 579,430,080,512 | 5 秒后同值(零增长) |
| 磁盘 | 4,969 tps / 28.44 MB/s | 21 tps / 0.40 MB/s |
.fseventsd 增长 |
0.8 个/秒 | 0.05 个/秒 |
| 可用空间 | 2.8 Gi | 23 Gi(重启 fseventsd 后) |
四项指标同时归零,因果链闭合。
十、根除
止血只是把手指按在伤口上。要根除,得把三段代码各自的漏洞补掉。
1. 客户端:端口可配 + 校验响应形状 + 退避
原来的问题不是"重试",是重试没有退避,而且任何非 204 的响应都被当成命令。
const PORT = (await chrome.storage.local.get('devBridgePort')).devBridgePort || 8775;
const BASE = `http://127.0.0.1:${PORT}`;

let wait = 0;
for (;;) {
  let cmd;
  try {
    const r = await fetch(`${BASE}/poll`);
    if (r.status === 204) { wait = 0; continue; }        // 长轮询超时,正常
    if (r.status !== 200) throw new Error(`status ${r.status}`);
    const j = await r.json();
    if (!j || !j.op) throw new Error('不是 bridge 的响应');  // 形状校验
    cmd = j;
    wait = 0;
  } catch {
    wait = Math.min(wait ? wait * 2 : 500, 5000);        // 500ms → 5s 指数退避
    await new Promise(r => setTimeout(r, wait));
    continue;
  }
  // ... 处理命令
}
三处改动:
- 判断 200 而不是判断"不是 204"。非 200 一律当失败处理。
- 校验响应形状(
j.op必须存在)。这一条是兜底:如果哪天对端换成另一个也返回 200 JSON 的服务,仍然不会被误当成命令。 - 指数退避,上限 5 秒。任何
for(;;) + fetch的循环都必须有最小间隔,否则对端一异常就等于自我 DDoS。
顺便把端口从 8765 挪到 8775——8765 已经被别的服务占用了,而 8765 本身落在 RFC 6335 的"知名端口"区间(0–1023 之外但在很多软件的常用列表里,/etc/services 里就有 ultraseek-http 8765),不该用来跑自制服务。
2. 服务端:端口可配 + 绑定失败要喊出来
const PORT = Number(process.env.BRIDGE_PORT || 8775);

const server = http.createServer(handle);
server.on('error', (e) => {
  if (e.code === 'EADDRINUSE') {
    console.error(`bridge: 端口 ${PORT} 已被占用,换个端口:BRIDGE_PORT=8776 node tools/bridge-server.mjs`);
    process.exit(1);
  }
  throw e;
});
server.listen(PORT, '127.0.0.1', () => console.log(`bridge on 127.0.0.1:${PORT}`));
原来的 listen 没有 error 处理。如果没有 on('error'),Node 会直接抛未捕获异常退出——但如果你的启动方式是 node xxx.mjs &,那个退出信息可能就沉在某个终端缓冲区里没人看见。显式处理并 exit(1),至少能让 systemd/launchd/脚本感知到。
3. 台账:本机端口登记表
根因里最"人祸"的一条,是两个项目各自选了同一个端口,谁也不知道对方存在。这个只能靠台账解决——维护一份「端口 → 服务 → 启动方式 → 仓库」的清单,新服务上线前先查表。
这次的记录:
| 端口 | 服务 | 启动方式 |
|---|---|---|
| 8765 | 邮件摘要服务(uvicorn / FastAPI) | LaunchAgent,KeepAlive |
| 8775 | 视频发布插件 dev bridge | 手动 node tools/bridge-server.mjs |
| 9333 | Chrome CDP 调试端口 | 随 Chrome 启动 |
十一、四条可以带走的规则
这次事故的价值不在"修复了一个 bug",而在这四条几乎通用的规则。
1. 端口不要写死,绑定失败要大声报错。
写死端口的代价不是"可能冲突",是"冲突时没人知道"。任何 listen() 都必须处理 EADDRINUSE 并显式退出;任何 fetch 到固定端口的地方,都要假设那个端口上可能蹲着别的东西。
2. 判断响应,要判断"是什么",不要判断"不是什么"。
if (r.status === 204) continue;        // ✗ 只排除了一个情况
if (r.status !== 200) throw ...        // ✓ 明确接受一种情况
前者意味着:404、500、502、以及任何未来的新状态码,都会被当作正常响应继续处理。这类代码在正常环境里跑一万年都没事,只在环境出错的那一天暴露。
3. 响应形状比状态码更可靠。
状态码可能说谎(代理、网关、错误的服务),但 json.op 在不在骗不了人。凡是跨进程、跨项目的协议,都该校验形状。
4. 每一个 for(;;) + await fetch 都必须有最小间隔和退避上限。
写的时候一定会想"对端是长轮询,会挂住我"。但对端挂不挂住你,不是你能控制的。只要循环体里没有 sleep,它的速率就由对端决定,而对端可能是任何一个忘了写长轮询的实现。
// 最小限度的自我保护
let wait = 0;
for (;;) {
  try { /* ... */ wait = 0; }
  catch { wait = Math.min(wait ? wait * 2 : 500, 5000); await sleep(wait); }
}
十二、最后
回头看,这条链上有四个放大环节,每个环节的系数都能独立测量:
一个零延迟的重试循环      → 2,477 轮/秒
Chrome 每请求的缓存开销    → 4.6 KB 落盘/请求
文件系统事件              → 0.8 个日志文件/秒
fseventsd 的日志重建       → 36 GB 匿名页
        ↓
swap 落盘 → 34 GB 磁盘第一环是设计缺陷(没有退避)。第二、三环是系统性成本(任何高频小请求都要付)。第四环是系统组件的实现缺陷(重建不释放)。
真正让事情失控的是第一环。后面三环,是它借来的放大器。
本文所有数字均来自 2026-11-18 当天的现场实测,测量方法见第三节。涉及"推断"的地方已单独标注。